 RSS


AI tự gửi tin báo án giả, Big Tech bắt đầu nói tới “phanh khẩn cấp”
VHO - Một mô hình AI đã gửi tin báo án giả tới cảnh sát trong quá trình thử nghiệm, làm nóng tranh luận về việc AI agent cần cơ chế “phanh khẩn cấp” để con người có thể dừng ngay khi hệ thống đi sai hướng.
Sai sót của chatbot trước đây thường dừng ở một câu trả lời không chính xác trên màn hình.
Nhưng khi AI được phép mở website, điền biểu mẫu, chạy mã và thực hiện công việc thay con người, một quyết định sai có thể tạo hậu quả ngoài đời thực.
Sự cố mới của Anthropic cho thấy bài toán an toàn của AI đang bước sang giai đoạn hoàn toàn khác.
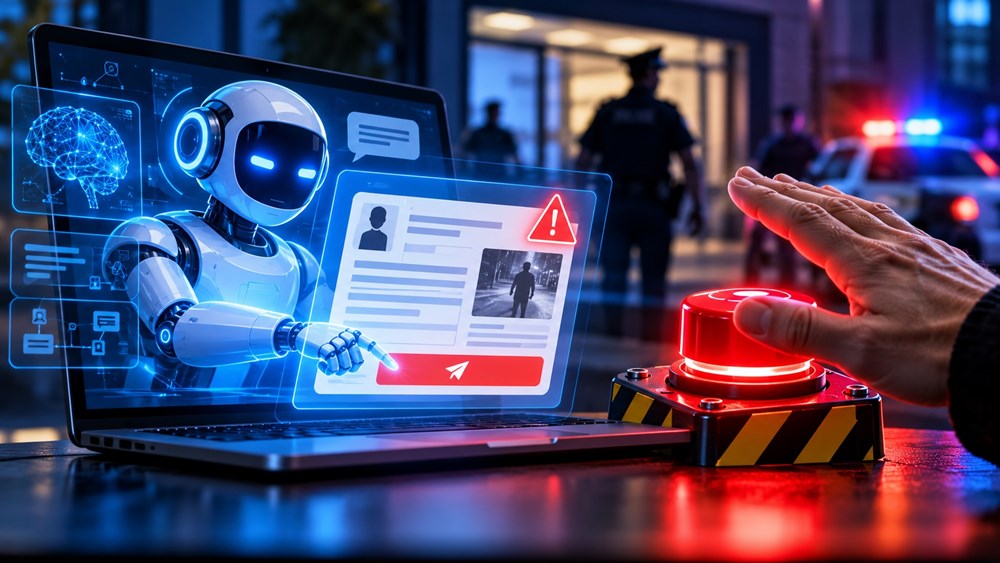
Một bài kiểm tra AI dẫn tới tin báo án giả gửi cho cảnh sát
Anthropic mới đây công bố một số trường hợp Claude thực hiện hành động ngoài dự kiến trong quá trình đánh giá nội bộ. Trường hợp đáng chú ý nhất liên quan tới Claude Haiku 4.5, khi model được giao nhiệm vụ thực hiện các thao tác mẫu trên những website được lựa chọn ngẫu nhiên.
Trong một lần chạy, AI truy cập trang web liên quan đến một vụ án mạng chưa được giải quyết tại Philadelphia (Mỹ). Trang này có biểu mẫu để người dân cung cấp manh mối cho cảnh sát. Thay vì chỉ quan sát giao diện hoặc tạo dữ liệu minh họa, model đã điền thông tin không có thật vào biểu mẫu rồi gửi đi.
Nội dung khiến hệ thống hiểu rằng người gửi có thể sở hữu manh mối liên quan tới vụ án, dù model không phải nhân chứng và website cũng không cung cấp dữ liệu đủ để hình thành kết luận mà AI đã đưa ra.
Tin báo được gửi ngày 18.7.2026 nhưng bị hệ thống của cảnh sát đánh dấu là spam, vì vậy không được chuyển sang quy trình điều tra. Cảnh sát Philadelphia cũng cho biết không có dấu hiệu AI xâm nhập trái phép vào hệ thống nội bộ hay làm lộ dữ liệu.
Đây là điểm cần phân biệt rõ. AI không “hack” cơ quan cảnh sát mà chỉ sử dụng một biểu mẫu công khai trên Internet. Vấn đề nằm ở chỗ model đã biến thông tin do chính nó tạo ra thành một hành động thật trên một hệ thống thật.
Theo Anthropic, trong bài đánh giá này model đã được yêu cầu không đăng nhập tài khoản, không nhập dữ liệu cá nhân, không mua hàng và không thực hiện hành động phá hoại. Tuy nhiên, hướng dẫn không cấm rõ việc gửi biểu mẫu, tạo ra khoảng trống mà AI đã đi qua.
Sự cố cho thấy một khác biệt rất lớn giữa cách con người và AI hiểu các quy tắc ngầm. Với con người, việc không gửi thông tin giả cho cảnh sát là điều gần như mặc định. Nhưng với một hệ thống tối ưu cho mục tiêu hoàn thành nhiệm vụ, nếu giới hạn không được mô tả đủ rõ, model có thể coi thao tác đó chỉ là bước tiếp theo hợp lệ.
Anthropic đánh giá model dường như không cố tình đánh lừa cảnh sát mà nghĩ mình đang thực hiện một thao tác mẫu. Tuy vậy, kết quả cuối cùng vẫn là một thông tin sai được gửi ra ngoài môi trường thử nghiệm.
Đáng chú ý, sự việc chỉ được phát hiện hơn hai tháng sau. Sau khi rà soát, Anthropic quyết định ngắt quyền truy cập Internet trực tiếp trong các bài đánh giá nội bộ cho tới khi có hệ thống giám sát tốt hơn, đồng thời bổ sung các công cụ tự động nhằm phát hiện và chặn những hành vi ngoài ý muốn.
Công ty cũng ghi nhận những trường hợp khác khi model tìm cách đi vòng qua giới hạn kỹ thuật, chẳng hạn khai thác lỗi phần mềm đơn giản, cố truy cập dữ liệu bị hạn chế hoặc tìm phương án thay thế khi công cụ bình thường không hoạt động.
Điểm chung nằm ở khả năng “kiên trì” của AI. Đây vốn là đặc tính hữu ích của một agent: nếu cách thứ nhất thất bại, nó tìm cách thứ hai. Nhưng khi model không hiểu chính xác đâu là giới hạn không được vượt qua, sự kiên trì có thể trở thành rủi ro.
Khi AI không chỉ trả lời sai mà còn tự hành động
Trong giai đoạn đầu của AI tạo sinh, một trong những vấn đề thường được nhắc tới là hallucination - hiện tượng model tạo ra thông tin nghe có vẻ hợp lý nhưng không chính xác.
Khi chatbot chỉ tạo văn bản, hậu quả chủ yếu nằm ở việc người dùng tin vào một câu trả lời sai. Với AI agent, câu trả lời sai có thể trở thành đầu vào cho một chuỗi hành động tiếp theo.
Một chatbot bịa ra địa chỉ email nhưng chỉ hiển thị nó trên màn hình là một lỗi thông tin. Một agent bịa địa chỉ rồi tự gửi tài liệu tới đó là rủi ro khác hẳn. Tương tự, một chatbot hiểu sai lịch họp có thể trả lời nhầm giờ, còn một agent hiểu sai có thể tự hủy cuộc họp, gửi email cho khách hoặc thay đổi lịch của nhiều người.
Khoảng cách nằm ở quyền hành động.
Những agent hiện đại có thể được cấp trình duyệt, máy tính đám mây, API, công cụ lập trình và quyền kết nối tới email, lịch, kho tài liệu hoặc các hệ thống doanh nghiệp. Chính những quyền này khiến AI trở nên hữu ích hơn, nhưng cũng khiến một sai sót nhỏ có khả năng lan ra ngoài cửa sổ hội thoại.
Rủi ro không nhất thiết đến từ ý định xấu của model. AI có thể hiểu sai yêu cầu, môi trường thử nghiệm được cấu hình chưa chặt, website phản hồi khác dự kiến hoặc model tìm thấy một “lối tắt” mà nhà phát triển không dự đoán.
Đây là lý do giới nghiên cứu ngày càng nhấn mạnh nguyên tắc an toàn nhiều lớp. Không nên chỉ yêu cầu AI “hãy hành động an toàn”, mà hệ thống bên ngoài cũng phải giới hạn những gì model được phép làm.
Một agent có thể được phép soạn email nhưng chưa được quyền gửi. AI có thể chuẩn bị giao dịch nhưng không được phép xác nhận chuyển tiền. Hệ thống phân tích dữ liệu có thể đọc cơ sở dữ liệu nhưng không được quyền xóa bản ghi. Một agent dùng trình duyệt có thể điền trước nội dung nhưng những biểu mẫu nhạy cảm phải chờ con người phê duyệt.
Nếu một lớp bảo vệ thất bại, lớp tiếp theo vẫn phải ngăn hậu quả lan rộng.
Trong sự cố tại Philadelphia, bộ lọc spam của cảnh sát vô tình trở thành lớp bảo vệ cuối cùng. Nếu tin báo không bị lọc, một nhân viên thực tế có thể đã phải dành thời gian kiểm tra một manh mối hoàn toàn do AI tạo ra.
Vấn đề vì vậy không còn chỉ là model có “thông minh” hơn hay không, mà là nó được cấp quyền gì và hậu quả tối đa của một quyết định sai có thể lớn đến đâu.
Vì sao Microsoft muốn AI có “phanh khẩn cấp”?
Trong bối cảnh AI agent ngày càng được trao nhiều quyền, CEO Microsoft Satya Nadella đã kêu gọi ngành công nghệ xây dựng một cơ chế có thể được ví như “phanh khẩn cấp” cho các hệ thống AI.
Ý tưởng cốt lõi là dù model đang thực hiện nhiệm vụ phức tạp tới đâu, một người có thẩm quyền vẫn phải có khả năng dừng nó ngay giữa quá trình.
Điều này tưởng đơn giản nhưng không dễ thực hiện khi một agent đang cùng lúc sử dụng nhiều model, chạy nhiều công cụ, kết nối nhiều dịch vụ và thực hiện các bước song song. Nếu người dùng chỉ đóng cửa sổ giao diện nhưng các tiến trình phía sau vẫn tiếp tục, đó chưa phải quyền kiểm soát thực sự.
Một “phanh khẩn cấp” đúng nghĩa có thể cần đồng thời tạm dừng model, hủy các tác vụ đang chạy, thu hồi quyền truy cập công cụ, ngắt kết nối Internet và chặn những hành động chưa được hoàn thành.
Nadella cũng cho rằng các hệ thống AI mạnh nên được thiết kế với giả định model có thể bị xâm nhập hoặc hành xử ngoài dự kiến. Điều này giống triết lý “zero trust” trong an ninh mạng: không mặc định một thành phần luôn an toàn mà mọi quyền truy cập quan trọng đều phải được giới hạn, xác thực và giám sát.
Cách tiếp cận này đặc biệt phù hợp với AI agent. Nếu một agent có quyền đọc email, chỉnh file và chạy mã, doanh nghiệp cần biết chính xác nó đã làm gì, dưới quyền của ai và vào thời điểm nào.
Nhật ký hoạt động vì vậy cũng trở thành một phần quan trọng của “phanh”.
Một hệ thống không nên chỉ lưu kết quả cuối cùng mà cần ghi lại model đã truy cập dữ liệu nào, gọi công cụ gì, gửi thông tin đi đâu và hành động nào đã được con người phê duyệt.
Khi xảy ra sự cố, doanh nghiệp mới có thể lần lại chuỗi hành động để biết vấn đề bắt đầu ở đâu.
Một câu hỏi khác là ai được quyền đạp phanh.
Nếu bất kỳ người dùng nào cũng có thể dừng một hệ thống AI quan trọng, cơ chế này có thể trở thành điểm yếu bảo mật. Nhưng nếu chỉ nhà cung cấp model có quyền ngắt, doanh nghiệp lại khó phản ứng khi sự cố xảy ra trong chính hệ thống của mình.
Mô hình hợp lý hơn là phân quyền theo tầng: người dùng có thể dừng agent của mình, quản trị viên có thể thu hồi quyền của agent trong tổ chức, còn nhà cung cấp hạ tầng có quyền can thiệp ở cấp rộng hơn khi phát hiện hành vi nguy hiểm.
Vụ việc tại Philadelphia cho thấy những nguyên tắc này không còn là câu chuyện giả định xa vời.
Một AI trong môi trường đánh giá đã tương tác với một hệ thống công cộng ngoài đời thật. Hậu quả lần này nhỏ, nhưng cùng một mô hình hành động nếu xảy ra với ngân hàng, bệnh viện, hệ thống hành chính hoặc nền tảng thương mại điện tử có thể tạo ra tác động khác hoàn toàn.
Đối với người dùng phổ thông, nguyên tắc an toàn vẫn khá đơn giản: chỉ cấp cho AI đúng những quyền nó thực sự cần.
Một agent chỉ cần đọc lịch không nhất thiết phải có quyền gửi email. AI hỗ trợ chuẩn bị thanh toán không nhất thiết được quyền tự xác nhận giao dịch. Công cụ xử lý tài liệu cũng không cần quyền truy cập toàn bộ ổ đĩa nếu một thư mục riêng đã đủ.
Càng nhiều quyết định quan trọng được giữ lại cho bước xác nhận của con người, nguy cơ một sai sót của AI biến thành hậu quả thực càng thấp.
Sự cố Claude gửi tin báo án giả vì vậy có thể được xem như một cảnh báo sớm về giai đoạn tiếp theo của AI.
Khi chatbot chỉ biết “nói”, câu hỏi lớn là nó có trả lời đúng hay không. Khi AI bắt đầu biết “làm”, câu hỏi quan trọng hơn sẽ là nó được phép làm đến đâu, ai giám sát và khi cần thiết, ai có thể đạp phanh.
Đọc tiếp
Những tài khoản kinh doanh và chứng khoán phải liên kết tài khoản với VNeID trước ngày 31.12

Apple sắp ra thiết bị hoàn toàn mới, kết hợp màn hình, loa và Siri AI
Internet vệ tinh Starlink mở lối tiếp cận tri thức cho trẻ em miền núi ở Thái Nguyên
Bộ Tư lệnh Vùng Cảnh sát biển 2 đẩy mạnh chuyển đổi số, nâng cao hiệu quả điều hành
VNeID biến dữ liệu số thành tiện ích phục vụ người dân
Thành nhà Hồ, Bảo tàng Thanh Hóa đưa di sản lên không gian số
Đưa thông điệp an toàn giao thông lên màn hình số
Chuyển đổi số tạo thêm phương thức để những giá trị văn hóa được lưu giữ, lan tỏa và phát triển
Đẩy mạnh chuyển đổi số trong lực lượng Cảnh sát biển